Cache de prefill
faxl met le cache de prefill sur SSD
Nous avons développé une technologie de cache pour l'IA locale qui déplace le cache de prefill sur SSD. Ce cache est peu coûteux et efficace, il survit aux redémarrages, il convient aux tâches d'agents longues et périodiques, et il vous aide à maîtriser votre consommation de tokens. Souvent, l'IA locale cesse ainsi d'être une expérience amusante et devient un outil qui fait du vrai travail.
Pourquoi faxl
Qu'est-ce qu'un agent ?
Sans que vous le voyiez, un agent IA est fait de centaines de prompts conçus à la main. Ils définissent sa personnalité, son code moral. Son âme. Chaque prompt que vous envoyez est enveloppé dans ce gabarit. « Bonjour Hal » peut consommer 100k tokens. L'automatisation par agents fait grossir les gabarits : il faut des prompts plus gros pour obtenir des résultats réguliers. Exemples, compétences, connaissances métier, historique compacté, règles, guides de style, rappels — tout cela entoure chacun de vos appels.
Le coût
L'IA locale a besoin d'un bon cache de prefill
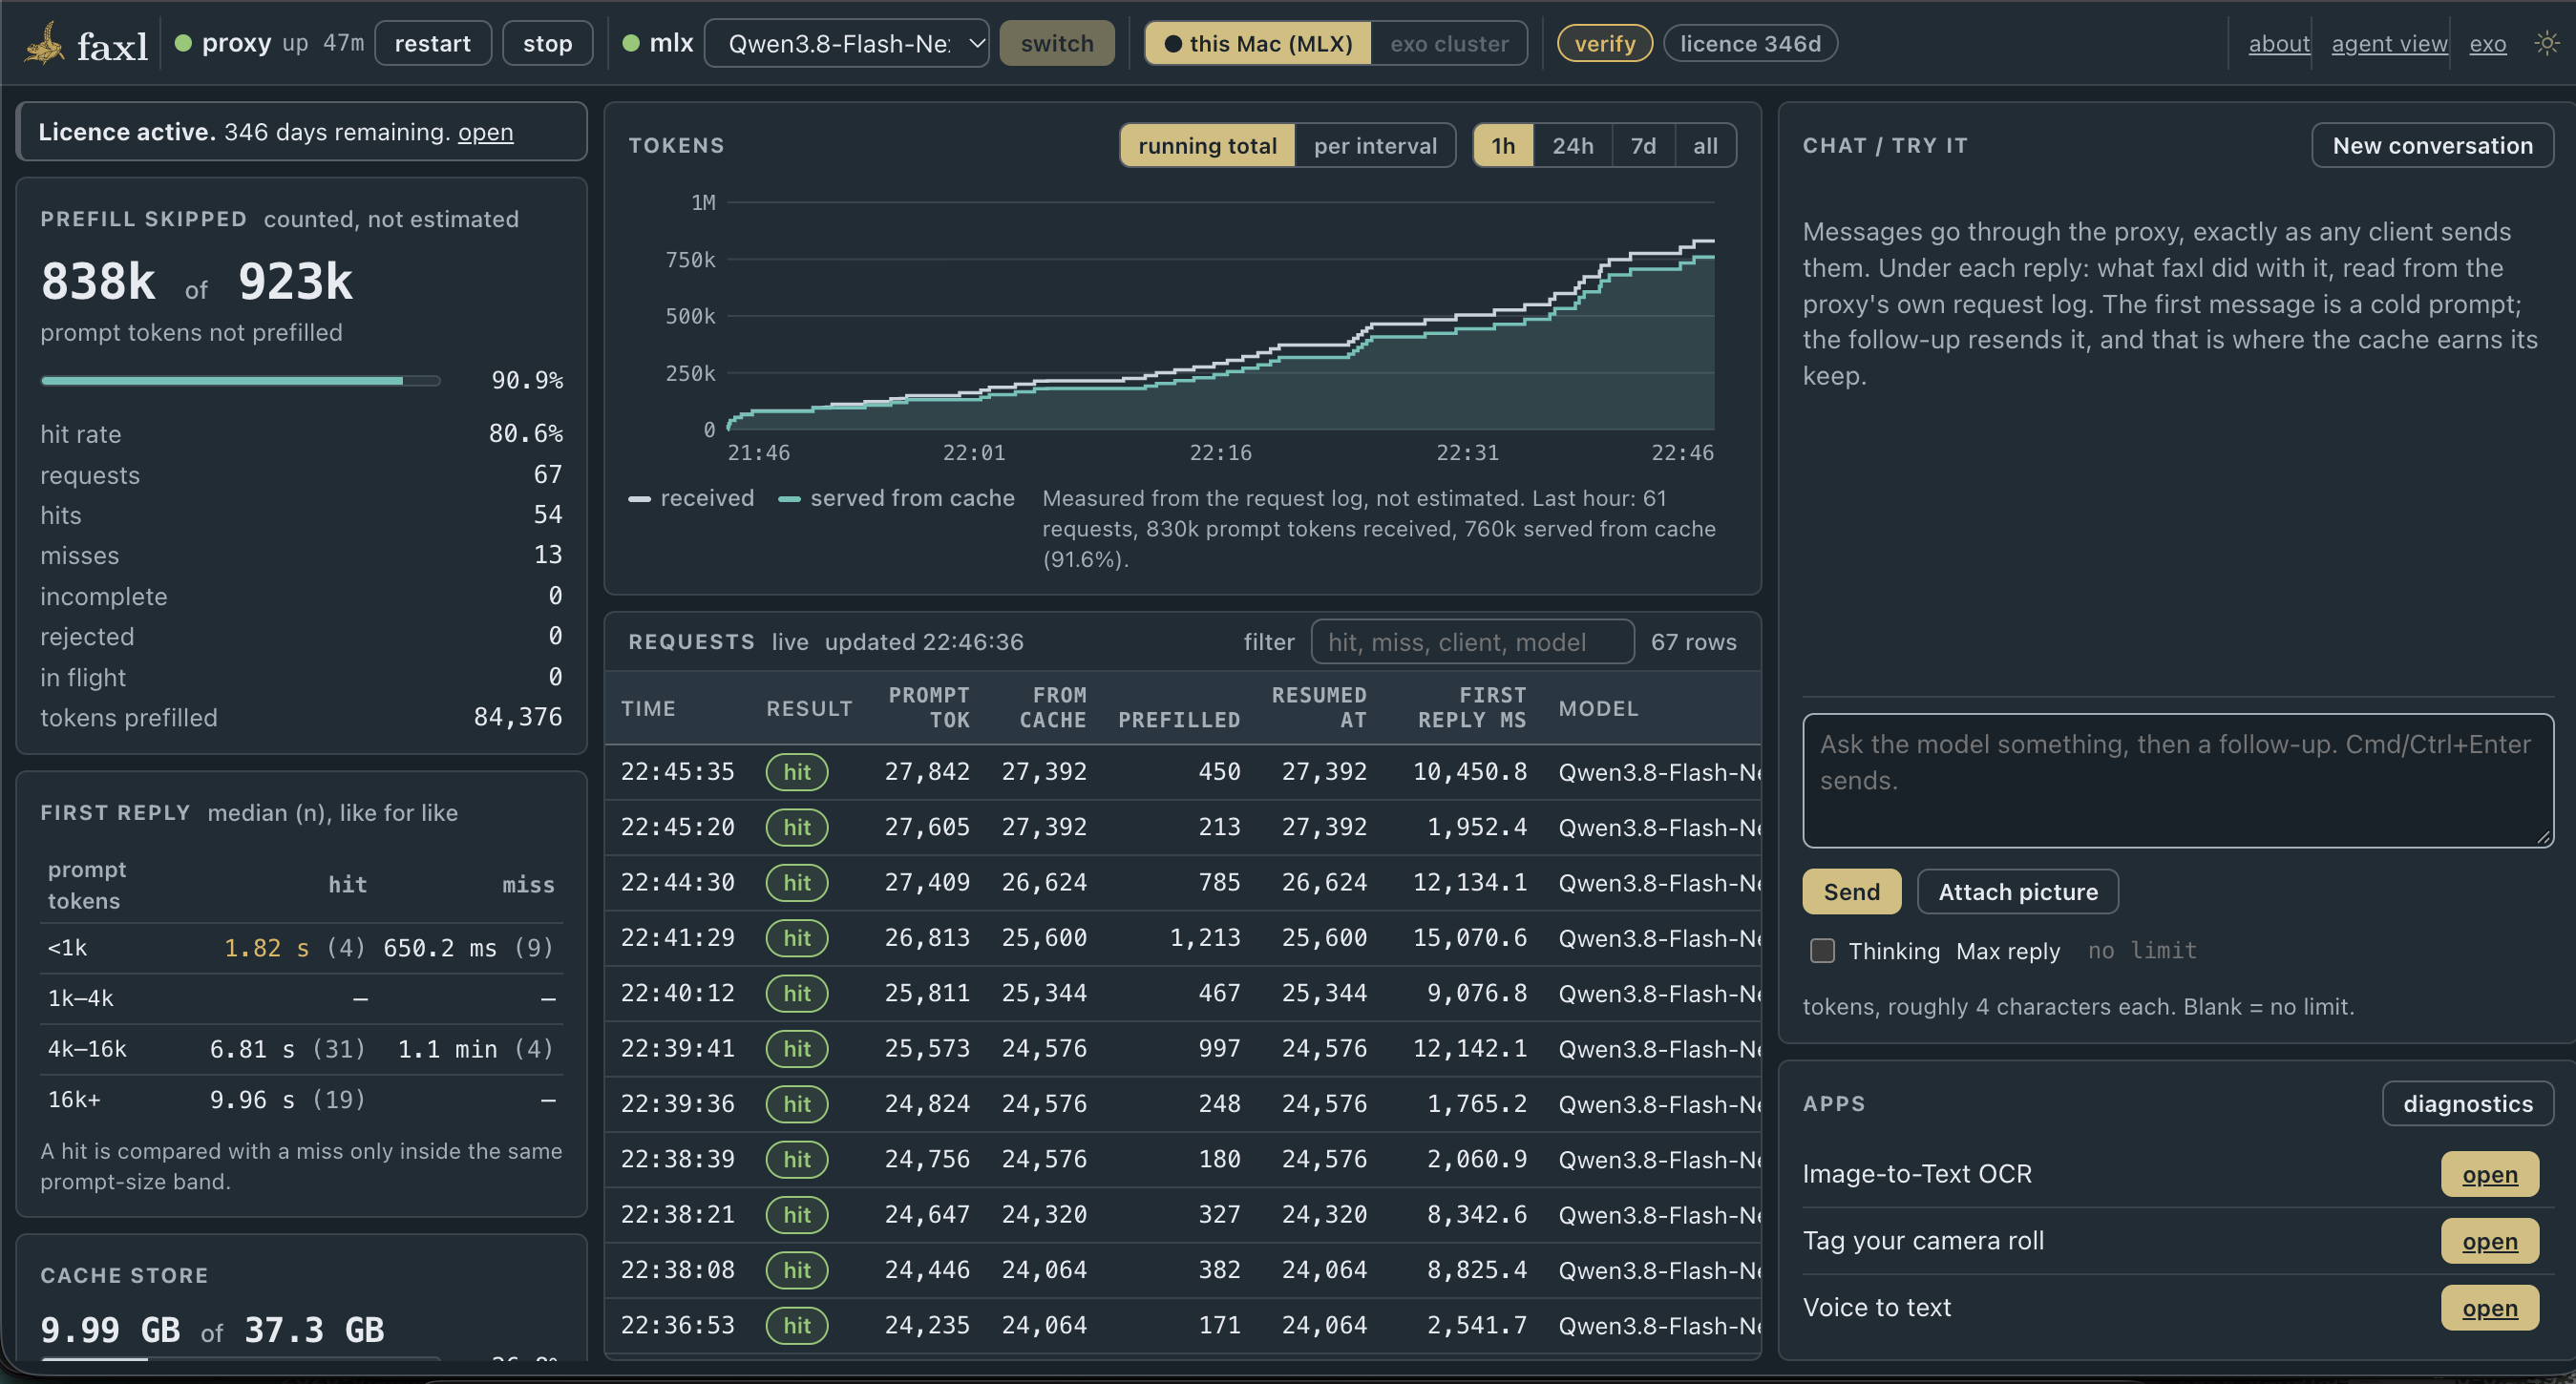
Sur un matériel limité, l'IA locale peut être lente. Pour l'accélérer, il faut mettre en cache tous ces gabarits. C'est ce qu'on appelle un « cache de prefill » — il réduit jusqu'à 90 % le délai avant le premier token et l'effort du GPU. Les caches de prefill actuels sont conçus pour des GPU de datacentre dotés d'énormes quantités de RAM, mais faxl est conçu pour vous. Il stocke le cache sur le disque local.
Le disque ne coûte pas cher, et mettre le cache sur disque vous donne un contrôle direct sur lui.
faxl
La pièce manquante
faxl est le logiciel qu'il vous faut pour faire tourner votre propre couche de cache devant vos propres modèles. Sur une session de code avec un agent, il saute 98 % des tokens de prompt et termine toute la session 4,4× plus vite, avec un résultat identique octet pour octet. Vous le gérez comme vous l'entendez. Il vous permet de quitter les services cloud et de passer au privé.
Mesures
Ce que ça donne sur du trafic réel
Mesuré le 9 octobre 2026 sur un MacBook Pro 128 Go (M3 Max), avec Qwen3.6-35B-A3B-4bit : huit tours d'un agent qui lit des fichiers, cherche, lance des tests et modifie du code, les résultats des outils étant reportés d'un tour à l'autre. Le test à froid part d'un stockage vidé juste avant, ce qui correspond au coût réel d'une toute première session. Répété avec Qwen3.8-Flash-Next-OptiQ-2bit : 98,1 % sautés, 3,1× plus vite, 8/8 identiques. Votre résultat dépend de la part de vos prompts qui se répète. faxl aide quand les prompts partagent de longs préfixes : prompts système, préambules RAG, questions-réponses sur documents, boucles d'agents. Si ce n'est pas votre cas, faxl vous donne les analyses pour savoir comment réorganiser vos prompts d'agents — les concevoir avec méthode et reprendre la main sur vos performances.
Aujourd'hui
Apple silicon aujourd'hui, NVIDIA ensuite
faxl tourne sur un Mac équipé d'une puce de la série M, via MLX — y compris sur un Mac Studio que vous avez déjà acheté et dont vous n'exploitez pas toute la puissance. Il fonctionne aussi sur plusieurs Mac reliés en Thunderbolt, ce qui permet de faire tourner un modèle trop gros pour une seule machine. Le portage NVIDIA/vLLM passe les mêmes tests d'identité octet pour octet sur GPU.
Gratuit pour un usage non commercial : une licence nominative, valable 3 mois, renouvelée gratuitement en vous réinscrivant.
Obtenir faxl — gratuit